OpenAI BioBasicsBench mäter AI på 100 våtlabbuppgifter
GPT-6 Astra når 66,7 procent mean reward vid xhigh, mot 43,8 procent för GPT-5.6 Sol.
OpenAI har publicerat BioBasicsBench tillsammans med bioteknikbolaget Ligo. Benchmarken mäter hur AI-agenter tolkar rå experimentdata i 100 rutinuppgifter från våtlabb, där misslyckade försök, tvetydiga bilder och motstridiga observationer ingår.
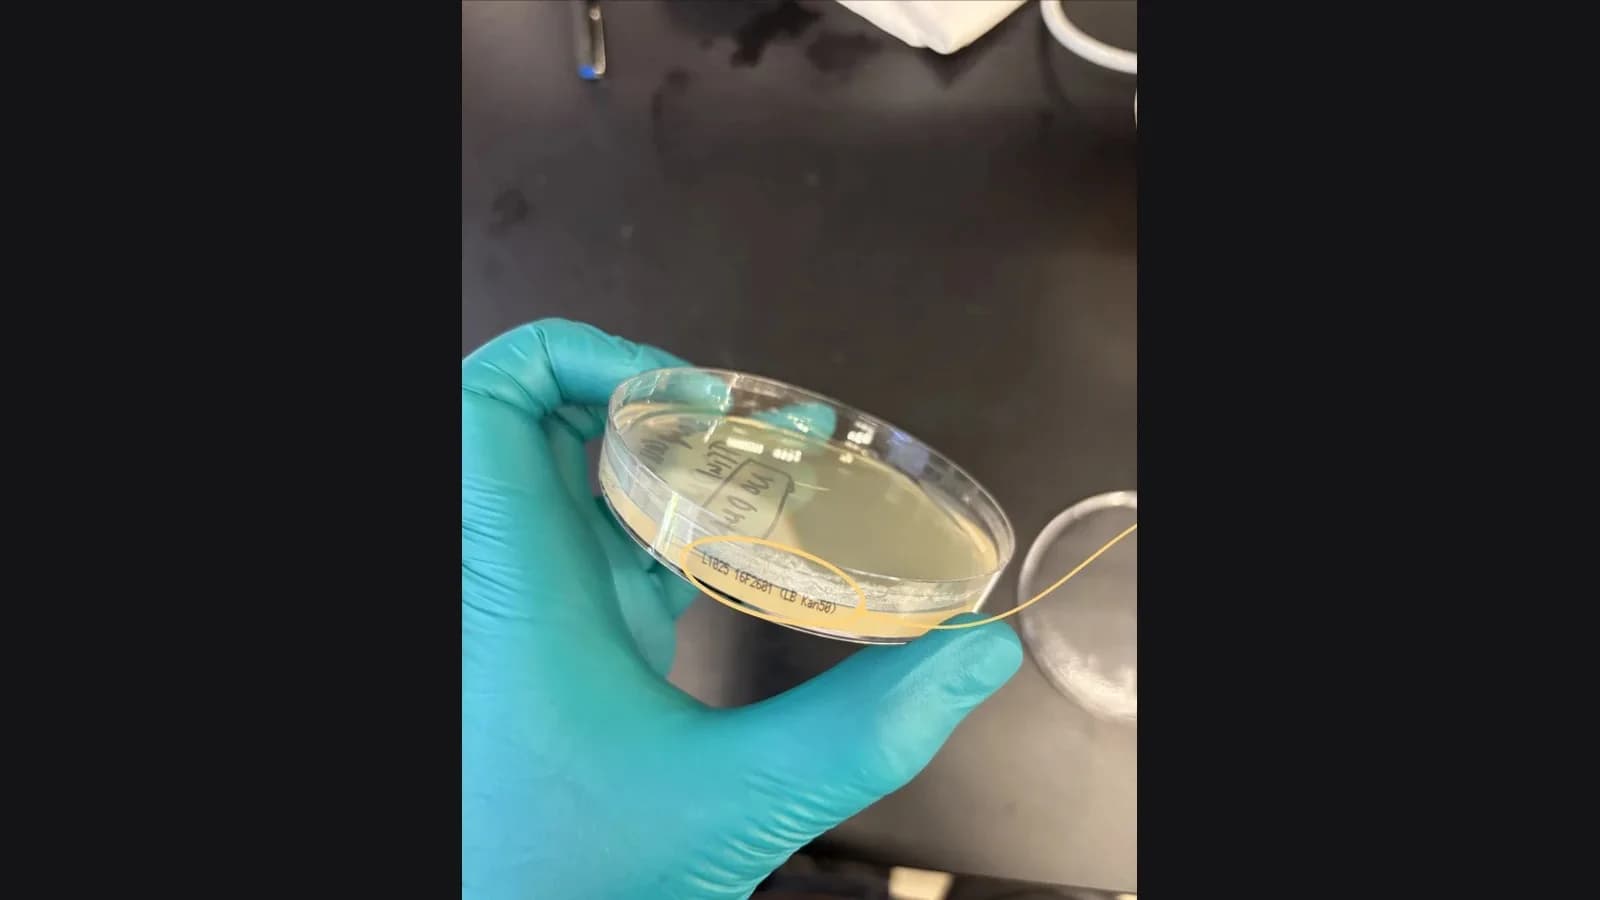
Uppgifterna spänner över proteinmetoder, imaging och cytometri, kvantifiering och assay, nukleinsyrametoder samt molekylär kloning. Indata kan vara gelbilder, kolonier, mikroskopi, instrumentexporter, sekvensfiler och film från bänken. Svaren bedöms mot rubriker med delpoäng, så en delvis korrekt analys syns i mean reward.
Vid xhigh, den högsta resonemangsinställningen som rapporteras för alla sju modeller, får GPT-6 Astra 66,7 procent mean reward (95-procentsintervall 60,3 till 73,1) och 4 704 utdatatokens per uppgift. GPT-6.1 Sol får 62,0 procent och GPT-5.6 Sol 43,8 procent. Sju modeller utvärderades i 37 lägen med fem försök per uppgift, totalt 18 500 resultat.
OpenAI visar också kvarvarande fel. I ett colony PCR-exempel grupperar Astra banden rätt men kopplar identiteterna baklänges och föreslår banorna 4, 6, 7 och 8 när referensen pekar på 5, 9 och 10. I ett annat fall räknas kolonier cirka 12 procent för högt. Bolaget skriver att högre poäng ännu inte betyder tillförlitliga labbbedömningar. Artikeln finns på openai.com.