Google lägger till TPU 8tx och TPU 8i Max
8tx ger konfidentiell inferens i hårdvaran. 8i Max dubblar beräkning, SRAM och HBM-bandbredd mot 8i.
Google utökar åttonde generationens TPU-portfölj med TPU 8tx och TPU 8i Max. Tillsammans med tidigare 8t och 8i blir det fyra TPU-system samma år, enligt Google.
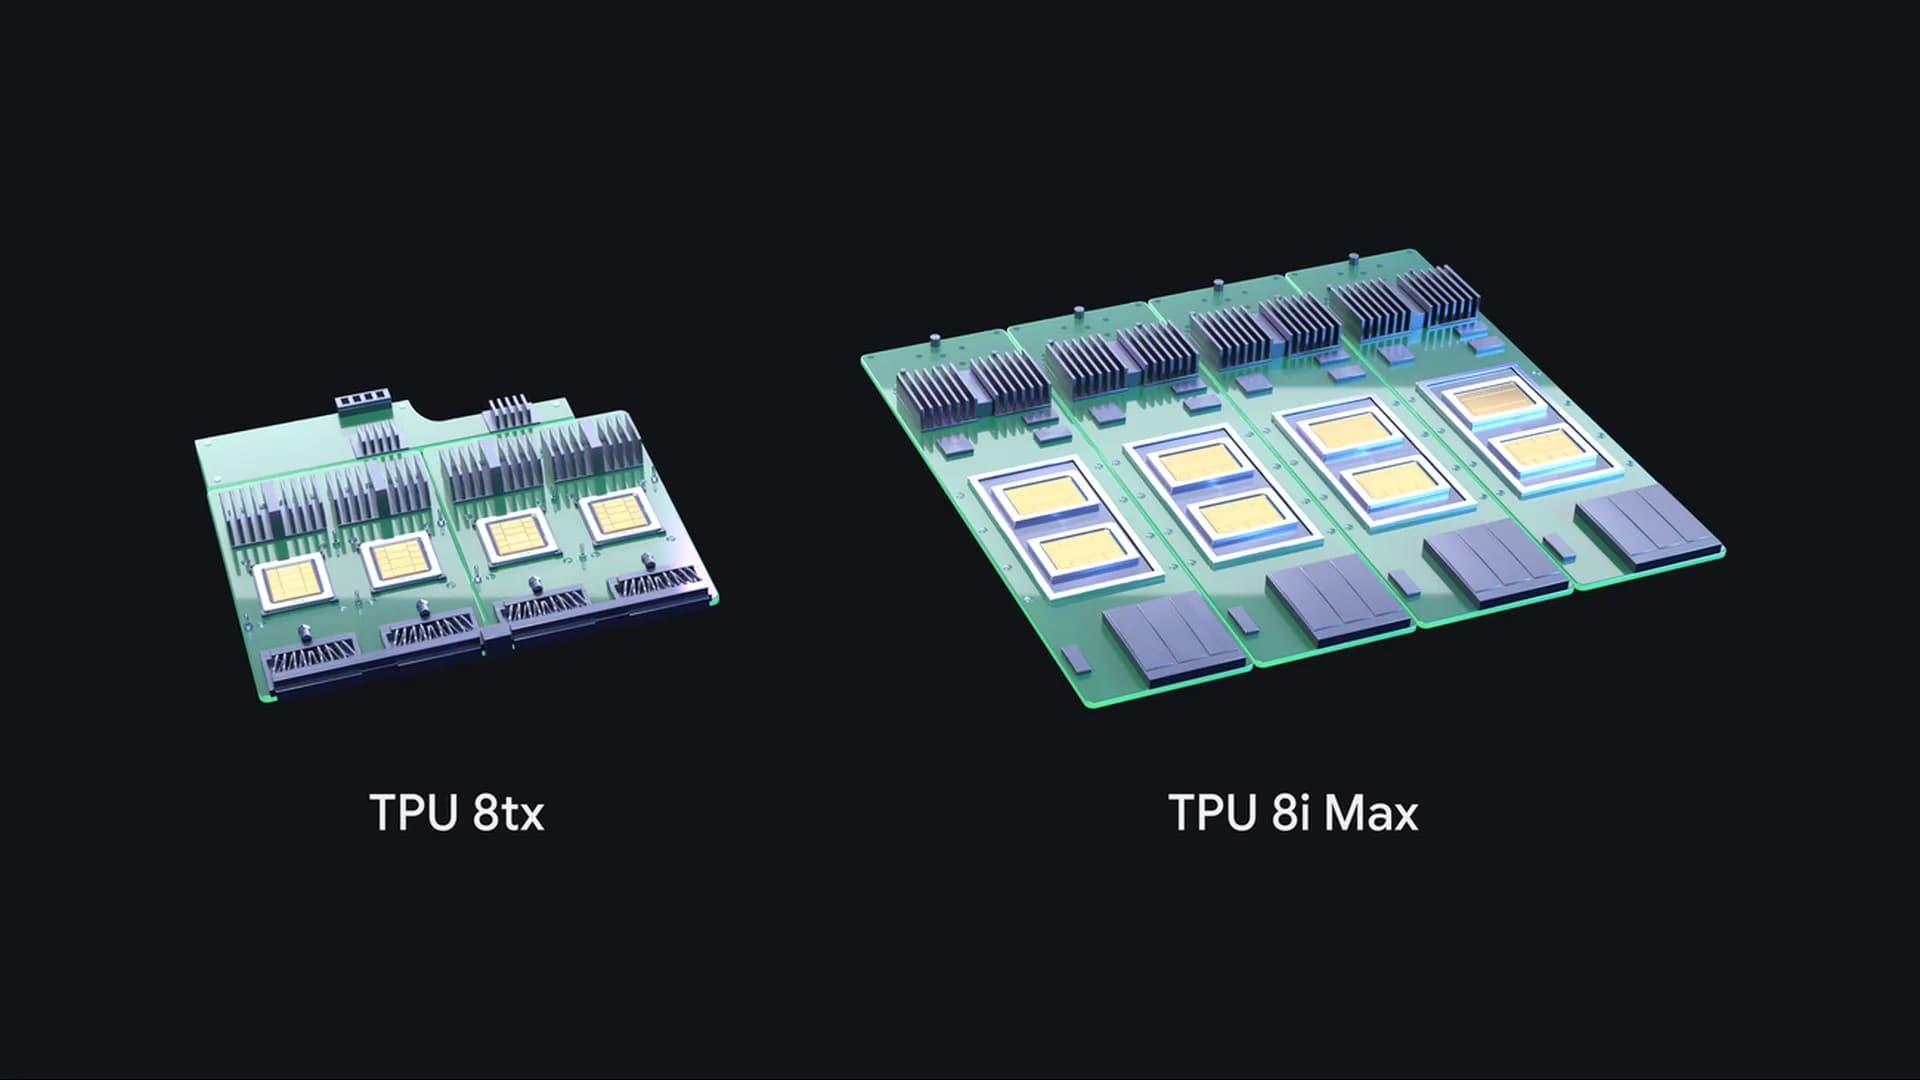
TPU 8tx är byggd för säker och konfidentiell inferens, och fungerar också för träning i mindre skala. Den använder samma kisel som TPU 8t och körs med värdar baserade på femte generationens AMD EPYC. Google skriver att känslig data och modellvikter hålls skyddade och isolerade även under aktiv användning. Med Boardfly-nätverket, samma låg latensnät som för realtidsresonemang, anger Google upp till dubbelt så låg latens jämfört med TPU 8t, med nära noll prestandaförlust. På samma system ska team kunna finjustera modeller, destillera stora modeller och träna agenter med förstärkningsinlärning utan att flytta känslig data mellan kluster.
TPU 8i Max
TPU 8i Max sätter två TPU 8i-chip i samma kapsel. Enligt Google ger det dubbel beräkningskraft, dubbel SRAM och dubbel HBM-bandbredd jämfört med TPU 8i, inom samma rackyta. Systemet är riktat mot stora kontextfönster och hög beräkningsdensitet per rack.
TPU 8t och 8i presenterades tidigare med upp till 2,7 gånger bättre träningsprestanda respektive 80 procent bättre prisprestanda för inferens mot föregående generation, enligt Google. Mer om de nya systemen finns i Googles blogg.