Ant Ling-3.2-flash tar text, bild och video med 1M kontext
560 miljarder parametrar totalt, 25 miljarder aktiva. API:t är gratis i två veckor efter lansering.
Ant Groups Ling-3.2-flash tar emot text, bild och video i samma modell. Enligt Ant Lings modelldokumentation har den 560 miljarder parametrar totalt och aktiverar 25 miljarder per inferenssteg, med en kontext på 1 miljon tokens.
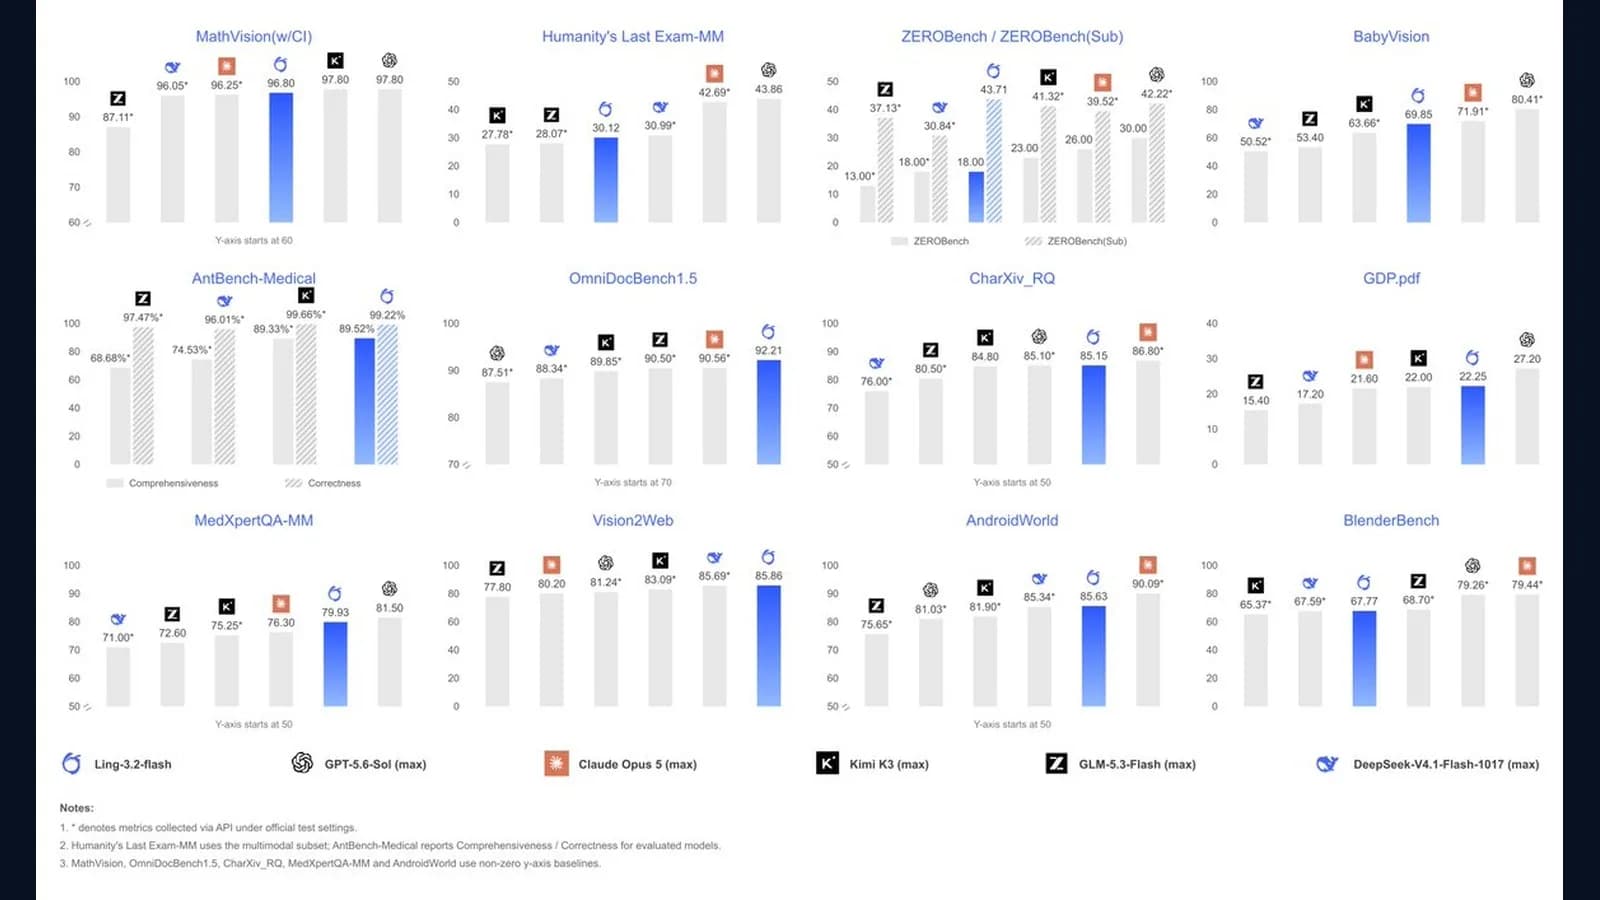
Ant skriver att fokus ligger på komplex visuell förståelse, multimodala långa agentuppgifter, 3D-förståelse och interaktion samt medicinsk multimodal användning. I dokumentationen anges att multimodal information ska kunna användas som underlag för resonemang, inte bara bildbeskrivning.
Du kan prova modellen i Ant Lings chattgränssnitt eller anropa den via API som följer OpenAI- och Anthropic-protokoll. Enligt changeloget är åtkomsten gratis de första två veckorna efter lansering.
Ant Ling visar också egna jämförelsediagram mot bland annat Claude Opus 5, GPT-5.6 och DeepSeek i lanseringstråden. Siffrorna där kommer från bolaget.