Amazon HOPE beskär MoE-experter efter hur de samverkar
Vid 50 procent beskärning får HOPE bäst snittplacering, med upp till 6,1 procentenheter bättre på agentisk kodning.
Amazon har publicerat HOPE, Higher-Order Pruning of Experts, en metod som beskär experter i Mixture-of-Experts-modeller utifrån hur de samverkar. Till skillnad från förstahandsmetoder som ger varje expert ett eget poäng tar HOPE hänsyn till parvisa interaktioner.
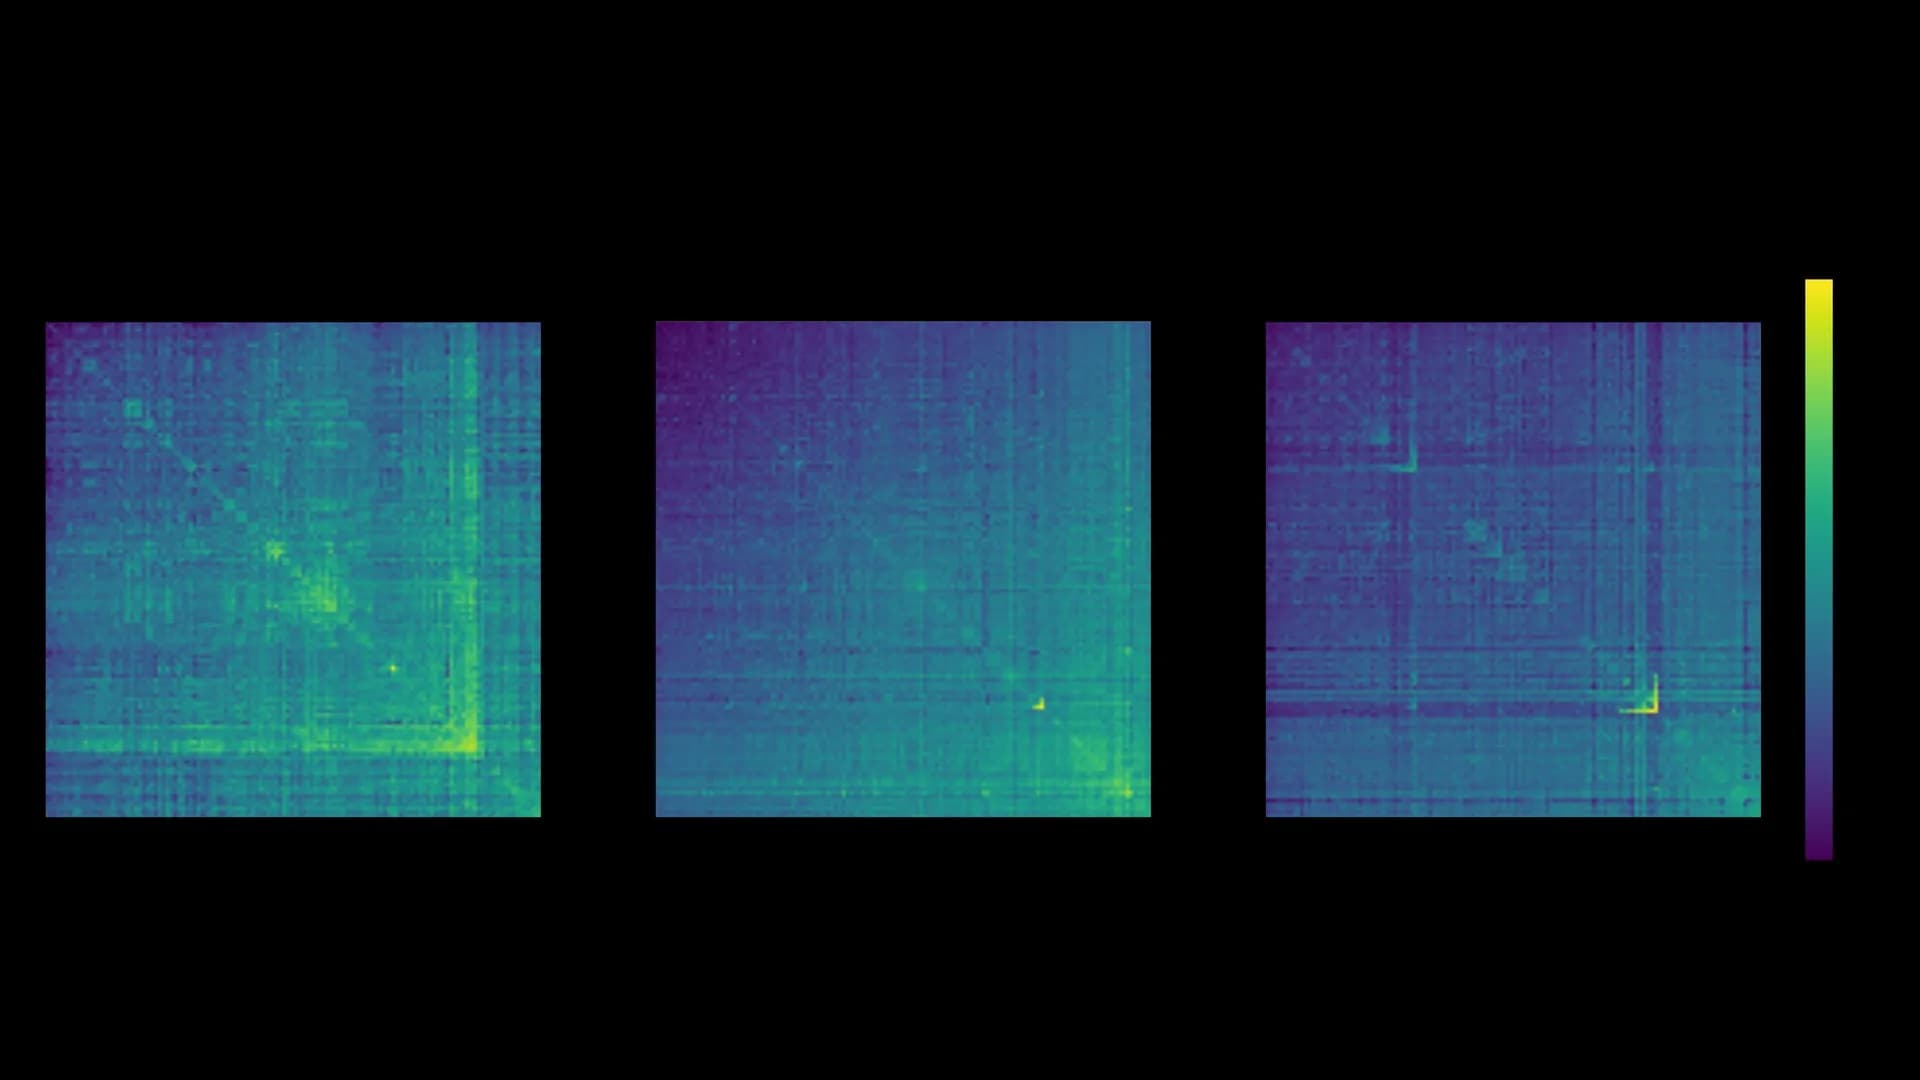
I en MoE-lager skickas varje token till ett litet antal experter. Enligt Amazon bildar experterna stabila grupper som aktiveras tillsammans. Om en expert i en sådan grupp tas bort kan resten fungera sämre, även om den borttagna experten ensam såg oviktig ut.
HOPE bygger under kalibreringen en interaktionsmatris F per lager. Diagonalen mäter enskilda experters vikt. Övriga värden mäter hur starkt två experter bidrar tillsammans. Sedan löses ett kvadratiskt program som väljer vilken mängd experter som ska bort under en given beskärningsbudget.
Resultat och verktyg
Metoderna jämfördes på Qwen3.5-122B, Qwen3.5-35B och GLM-4.5-Air, med kalibrering på Evol-CodeAlpaca och SWE-Bench Verified. Vid 50 procent beskärning fick HOPE snittplacering 1,58 av fem metoder, mot 2,42 för näst bästa metoden REAP. På Qwen3.5-35B-A3B vid 50 procent beskärning fick HOPE 42,3 på SWE-Bench Pro, mot 41,8 för obeskuren modell och 36,2 för REAP. Amazon skriver att fördelen är störst vid aggressiv beskärning och på agentisk kodning, med vinster på upp till 6,1 procentenheter mot näst bästa metod.
Paketet hop körs i tre steg: calibrate, solve och prune. Kalibreringen är en forward-pass. QP-lösningen tar enligt Amazon 1 till 2 sekunder per lager. Resultatet är en vanlig Hugging Face-checkpoint. Kod finns på github.com/awslabs/HOPE och artikeln på arXiv.